dg5W, MLPerf GPU 4장급 처리량 1위 기록
엔비디아, 구글, 마이크로소프트 애저, AMD, 인텔, 델, HPE, 시스코 등 글로벌 기업이 참가하는 국제 AI 성능평가 ‘MLPerf Inference v6.1’에 국산 AI 서버가 이름을 올렸다.
국내 기업이 GPU를 직접 액체로 식히는 방식으로 국제 공인 성능평가를 통과해 해외 서버와 같은 기준에서 성능을 검증받았다고 매니코어소프트가 밝혔다. PCIe 카드형 GPU를 직접액체 냉각한 서버가 MLPerf Inference에 등재된 것은 글로벌 제조사를 포함해 이번이 처음이며, 국산 서버의 액체냉각 등재로도 첫 사례라고 업체 측은 밝혔다.
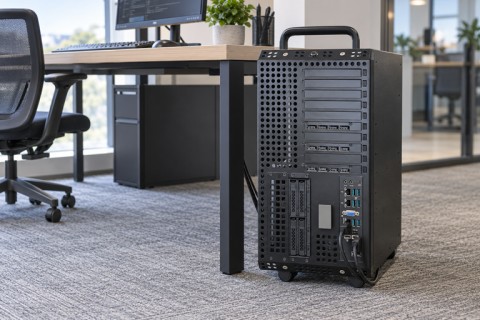
매니코어소프트의 직접액체냉각 AI 서버 ‘DeepGadget dg5W’(사진=매니코어소프트)
실서비스 조건(Server) 처리량은 같은 평가에 제출된 가속기 4장 시스템 6종 가운데 1위로, 동일 GPU를 탑재한 글로벌 제조사 서버를 웃돌았다. 본 평가는 과학기술정보통신부, 정보통신산업진흥원(NIPA)이 지원하는 ‘친환경·고효율 AI 데이터센터 테스트베드 조성 및 실증 지원’ 사업의 일환으로 한국정보통신기술협회(TTA)와 공동 수행했다.
이 서버는 매니코어소프트가 자체 설계한 직접액체냉각 AI 서버 ‘DeepGadget dg5W’다. 매니코어소프트는 dg5W의 결과가 MLCommons의 검증을 거쳐 공식 결과로 공개됐다고 23일 밝혔다.
이번 평가의 시험과 성능 최적화, 국제 심사 대응은 국가 공인 시험인증기관인 TTA가 맡았다. dg5W는 워크스테이션 형태로 일반적인 사무실과 연구실에서 별도의 서버실 구축 없이 사용에 용이하다.
MLPerf는 125개 이상의 기업·대학·연구기관이 참여하는 AI 엔지니어링 컨소시엄 MLCommons가 주관한다. 참가 기관은 모두 동일한 AI 모델과 정확도 기준으로 성능을 측정하고, 결과는 참가 기관 간 상호 검증을 거쳐 공개된다. 이번 v6.1에는 역대 최다인 30개 기관이 참가했다.
생성형 AI가 답변을 만들 때 처리하는 텍스트의 최소 단위를 ‘토큰’이라고 한다. dg5W는 메타의 언어모델 Llama 3.1 8B 평가에서 1초에 약 2만4500개의 토큰을 처리했다. 요청이 연속으로 들어오는 실서비스 조건(Server)에서는 응답 지연시간 기준을 충족하면서 시스코 서버를 웃돌았다. 실제 서비스 조건에서도 서버가 낼 수 있는 최대 성능의 99.99%를 그대로 발휘했다. 같은 GPU를 쓴 다른 서버 3종은 97.2~98.3%였다. 국내 자체 기술로 설계한 고성능 AI 서버가 글로벌 제조사의 서버와 같은 모델, 같은 기준으로 평가받아 실서비스 조건의 두 지표에서 가장 높은 수치를 공식 결과로 남긴 것이다.
박정호 매니코어소프트 대표는 “고성능 GPU는 해외에서 들여오더라도 그 성능을 온전히 끌어내는 AI 서버는 국내 기술로 설계할 수 있다는 것을 공개 검증 절차로 확인받았다”며 “국내에서 설계한 서버가 글로벌 제조사의 서버와 같은 모델, 같은 기준으로 평가받아 실서비스 조건에서는 같은 GPU 4장을 쓴 글로벌 제조사 서버보다 높은 수치를 기록했다”고 말했다.
이어 “지연시간 기준을 지키면서도 최대 성능의 99.99%를 유지한 것은 GPU 성능을 실제 서비스에서 그대로 쓸 수 있다는 의미”라며 “앞으로도 공개 벤치마크를 통해 국산 AI 인프라의 성능을 검증받겠다”고 덧붙였다.
<저작권자(c)스마트앤컴퍼니. 무단전재-재배포금지>